

들어가는 글
“확보할 수 있는 리소스부터 고민해 보세요”
최근 1인 개발을 고민하고 있다는 생각을 털어놓자, 그 개발자가 내게 건넨 조언이었다.
chatGPT와 Claude 등 LLM의 눈부신 발전은 코딩 기술이나 그림 솜씨 없는 사람도 얼마든지 1인 개발에 뛰어들 수 있는 시대를 열어 젖혔다.
하지만, ‘어떻게’ 그런 리소스를 생산할 것인지, 그리고 ‘얼마나’ 괜찮은 퀄리티의 리소스를 만들어 게임에 적용할 수 있는지 등 노하우를 얻는 건 여전히 쉽지 않은 일이었다.
그런 필자에게, 이미 게임을 10개도 넘게 출시한 그 개발자의 조언은 꽤 깊은 인상을 남겼다.
최근 구직에 겸해 1인 개발에 관심을 갖게 됐다. 다양한 이유가 있지만 가장 큰 건, 기왕 이렇게 쉬게 된 김에 이 시기에 바짝 ‘나만의 게임’을 한번 만들어보자는 동기가 생겼기 때문이다.
그래서 한창 게임 컨셉 기획서를 쓰다가 문득 그 개발자의 조언이 생각났다. 그래서 리소스 확보를 우선해야겠다는 생각에 기획을 잠깐 멈추고 리소스 생산부터 해보기로 했다.
이 글은 그 조언에서 출발해, 기획자 혼자 ComfyUI로 비주얼노벨 스탠딩 한 벌을 만들어 본 기록이다.
그 개발자에게서 들은 말이 하나 더 있다. AI 티가 나는 아트는 여전히 게이머들에게 반감을 살 수 있고, 그것을 줄이는 것도 노하우이자 실력이라는 것이었다. 나는 이 말에 동감했다. 그래서 나중에 고치는 게 아니라, 리소스를 만드는 단계부터 AI 느낌을 가급적 줄인 채 시작하기로 했다.
예쁜 한 장보다, 반복해서 만들 수 있는 한 벌
내가 만들고 싶은 건 2D 미소녀 게임, 그중에서도 비주얼노벨이다. 이 장르에서 플레이어가 가장 오래 보는 것은 배경 위에 서 있는 캐릭터 스탠딩이다. 그래서 가장 먼저 확인할 리소스를 2D 스탠딩으로 정했다.
다만 예쁜 그림 한 장으로는 부족하다. 게임에 쓰려면 적어도 아래 조건을 만족해야 한다.
| 조건 | 이유 |
|---|---|
| 같은 캐릭터를 반복해서 뽑을 수 있다 | 장면마다 얼굴이 달라지면 캐릭터가 되지 않는다 |
| 표정을 바꿀 수 있다 | 대사마다 감정이 바뀐다 |
| 눈을 깜빡이고 입을 움직일 수 있다 | 멈춘 그림에 살아 있는 느낌을 준다 |
| 배경이 투명하다 | 어떤 배경 위에도 올려야 한다 |
흔히들 말하는 미연시나 비주얼 노벨에서 쓰이는 2D 스탠딩 이미지가 위에 해당한다.
일단 그런 ‘미연시풍 그림’을 만들어보는 게 첫 목표가 되었다.
왜 ComfyUI와 Anima였나
앞서 말했듯 이미지 생산 도구는 ComfyUI로 정했다. 필요한 건 그림 한 장이 아니라 같은 캐릭터를 같은 화풍으로 계속 뽑아낼 수 있는 공정이었다. ComfyUI는 모델·시드·설정을 노드로 고정해 두고 바꾸고 싶은 부분만 바꿀 수 있다. 생산성과 화풍 일치를 함께 따졌을 때, 재현 가능한 파이프라인을 만들기에는 GPT나 다른 도구보다 Comfy가 더 유리하다고 판단했다.
체크포인트(그림체를 결정하는 기본 모델)는 Anima를 골랐다. Civitai에서 처음 본 모델이었는데, 예시로 올라온 블루 아카이브 히나와 건담 이미지를 보니 내가 본 모델 중에서 AI 느낌이 가장 덜했다. AI 티를 줄이고 싶었던 나에게는 그것이 그 모델을 선택한 가장 큰 이유였다. 그렇게 반년 만에 ComfyUI를 다시 켰다.
필자의 블로그를 계속 보고 계신 독자분들은 기억할 것이다.
지난 4월에는 Illustrious 계열 체크포인트로 서브컬처풍 미소녀 일러스트를 만드는 과정을 「ComfyUI로 서브컬처풍 게임 미소녀 일러스트 만들기」에 정리한 적이 있다. (ComfyUI의 기본 노드 구성이 처음이라면 그 글을 먼저 보는 것도 좋다.)
물론 그때도 나름 만족스러운 일러스트 생산을 했기에 글을 올렸던 기억이 난다.
그런데 그때의 목표가 잘 나온 일러스트 한 장이었다면, 이번 목표는 게임에 그대로 넣을 수 있는 스탠딩 한 벌이었다.
그리고 이번 작업은 그때와 달리, 내 손을 최대한 ‘덜가게’ 만들고 싶었다. 일일히 프롬프트를 찾고 노드를 연결하고, 핀터레스트에서 원하는 화풍을 찾는 등의 일도 생각보다 게임 개발 일정을 많이 소비했던 게 기억에 났다.
그래서 이번 작업은 최대한 ‘게으르기로’ 했다. 가급적이면 손이 타는 일은 조금 대화를 나눠보고 바로 Claude, GPT에게 던졌다.
이미 5년 이상의 현업 경험이 있는 필자이지만, 이렇게 맨땅에 헤딩하듯 제로부터 비주얼노벨을 만드는 경험은 필자 또한 처음이다.
이 글은 게임 개발 과정에서 2D 서브컬처풍 미소녀 리소스를 생산성 있게 만들고 싶어하는 사람에게 조금이라도 도움이 되고자 필자의 경험과 AI를 쓴 방법을 공유하고, 나중에 같은 과정을 다시 밟을 나를 위한 참고 자료로 남기고자 작성했다.
Anima Turbo로 일상감 있는 미연시풍 찾기
내가 원한 건 일상감 있는 미연시풍
이번에 만들 게임은 한 마디로 ‘어릴 적 살았던 시골로 돌아간 청년이, 소년 시절 만났던 소녀와 재회하는 이야기’로 잡아보았다.
그래서 이번 화풍은 판타지나 SF가 아니라 ‘일상감’이 가장 중요했다.
그럼에도 서브컬처 원화 특유의 매력이 돋보여야 했으며, ‘남성향’ 게임을 목표로 하기에 어느 정도의 섹시 어필과 캐릭터의 매력을 필요로 할 것으로 예상했다.
그런 목표를 달성하기 위해 가장 적절하다고 생각했던 화풍은 애니메이션 느낌이 나는 셀식 작화보다는 어느 정도 고밀도 후처리를 한 미연시(게임 CG) 그림체였다. 화려한 판타지 의상보다는 가벼운 일상복을 입고 서 있는, 동네에서 마주칠 법한, 그럼에도 서브컬처적인 매력을 가진 비주얼의 히로인이 필요했다.
AI 티를 줄이는 것도 실력
여기서 개발자의 두 번째 조언(AI 티를 줄이자)이 다시 떠올랐다. 그래서 GPT나 Claude가 제공하는 프롬프트만을 고스란히 복붙하기보다는, 아예 필자가 플레이했던 미연시 캐릭터의 스탠딩 일러스트를 전달하며 화풍을 잡아보려고 했다.
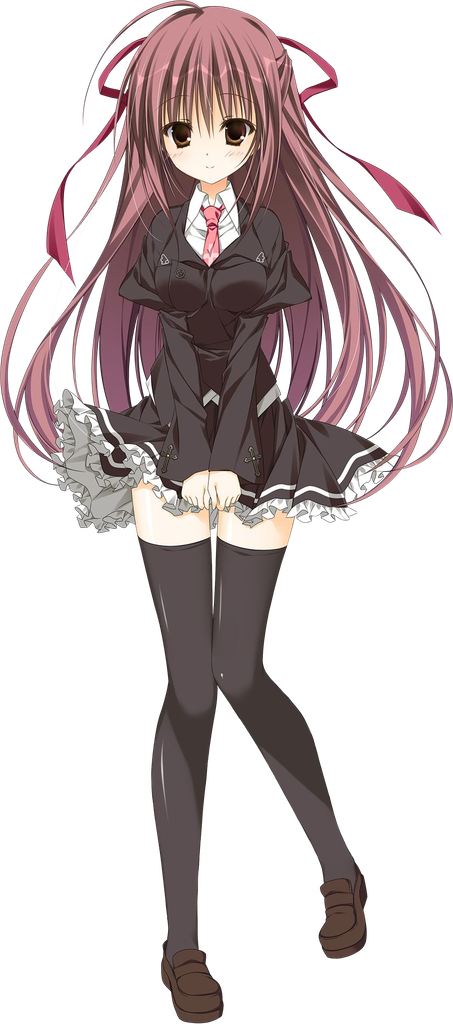

처음엔 makura의 『사쿠라의 시』 같은 그림체를 떠올렸다가, 생각보다 그림이 조금 연식(?)이 있어보이는 느낌이 들어서 좀 더 현대적인 쪽으로 Yuzusoft풍 그림체까지 탐색 범위를 넓혔다.
Turbo 덕분에 빨랐던 탐색
이번에 사용한 체크포인트인 Anima는 흥미롭게도 ‘Turbo’라는 모델을 제공한다.
이는 말 그대로 이미지 생성 속도가 빠른 ‘초안 특화 모델’인데, 앞서 필자가 익숙했던 SDXL 등을 비롯해, 그동안 써본 다양한 체크포인트 중에서 가장 ‘이미지 생성 속도’가 빠른 모델이었다.
프롬프트를 조금이라도 바꾸거나 마음에 안드는 화풍이 나오면 길게는 수 분을 기다려야했던 과정이, Turbo 모델을 쓰자 수 초 내로 줄어들었다.
Anima Turbo는 10스텝 만에 결과가 나와서, 바꿔 보고 싶은 게 생기면 바로 확인할 수 있었다.
앞서 조정한 프롬프트가 바로바로 결과물로 나오자 이미지 생성 작업이 꽤 즐겁고 재밌게 다가왔다.

설정은 다음과 같다. 터보 모델이라 CFG를 1로 두고 스텝도 적게 쓴다.
| 항목 | 값 |
|---|---|
| 체크포인트 | Anima Turbo (v1.1) |
| 해상도 | 768 × 1344 (세로 전신) |
| 스텝 / CFG | 10 / 1.0 |
| 샘플러 | euler, simple |
| 업스케일 | RealESRGAN x4 anime 6B로 4배 후 0.5배 축소 (최종 1536 × 2688) |
전신샷은 얼굴이 작게 그려져 눈매가 뭉개지는 현상이 발생했다.
그래서 이미지 생성 후처리 단계에 FaceDetailer 노드를 연결해 얼굴만 크게 다시 그리도록 했다. 그러자 눈매 뭉개지는 문제도 해결되고 그림의 전반적인 퀄리티와 밀도감도 ‘터보’ 치고는 잘 나왔다.
한 벌로 움직이게: 표정, 눈 깜빡임, 립싱크
왜 처음부터 구조를 잡았나
마음에 드는 화풍의 전신샷 이미지의 약 80% 수준까지 나오자, 나는 바로 표정 생산 작업으로 넘어갔다. 그림을 더 다듬기 전에 구조부터 잡고 싶었기 때문이다.
실무를 해 보니 회사마다 게임 리소스를 관리하는 방식도, 엔진에 적용하는 방식도 달랐다. 이걸 초반에 고려하지 않으면 나중에 프로젝트 리소스 용량이 불필요하게 커지는 일이 생길 것 같았다. 표정 10개를 전신 그림 10장으로 저장하면, 눈을 감은 그림과 입을 벌린 그림까지 합쳐 캐릭터 하나에 전신 30장이 된다.
또 하나는 생산성이다. 나는 ComfyUI 구조를 한 번 잡아 두면, 그다음부터는 캐릭터 이름과 프롬프트 외에는 거의 손대지 않는 수준까지 자동화하고 싶었다. 캐릭터가 늘어날 때마다 노드를 복사하고 연결하는 일은 피하고 싶었다.
Claude에게 이 두 가지를 조건으로 걸고 방법을 찾아 달라고 했다. Claude는 내 PC의 ComfyUI를 직접 조작하며 노드를 연결했고, 기존 노드로 안 되는 부분은 파이썬으로 커스텀 노드를 짜서 채웠다.
과거 필자가 하나하나 노드를 연결하고 최적의 배치를 위해 고민했던 과정이, 이제는 Claude가 배치와 그룹화, 노드 연결까지 자동으로 해주니 굉장히 편리했다.
몸은 그대로, 얼굴만 다시 그린다
첫 번째 원칙은 스탠딩 이미지를 다시 뽑지 않고 표정을 늘리는 것이다.
표정을 만들 때마다 스탠딩까지 새로 뽑으면 아주 미세한 머리칼 한 올과 옷 주름만 달라져도 이전 표정을 쓸 수 없기 때문이다. 그래서 하나의 기준점을 세우고 나면, 그 스탠딩을 고정해 두고 얼굴만 다시 그리는 방식을 취했다.
처음 표정 제작 노드를 만들 땐, 표정 하나마다 노드가 하나씩 필요했다. 예를 들어, smile, angry, sad, crying이라는 표정을 만든다면, 스탠딩 하나에 표정 노드가 4개가 연결되는 식이었다. 그러다보니 표정을 10개만 만들어도 노드가 10개 필요했고 그 연결은 기하급수적으로 복잡해졌다.
그래서 ‘쓸 표정 목록’을 지정했다. 그리고 그 목록을 노드가 아니라 텍스트 구조로 뺐다.
표정 목록은 노드가 아니라 텍스트로 빼서 고정시켰다.
예를 들어, ‘sora’라는 캐릭터가 있다면, 이 캐릭터 스탠딩을 만들 때, 후속 노드의 목록에 smile, grin, angry, surprised, sad, crying, embarrassed, pout, smug, sleepy의 10종을 넣어두었다. sora를 만들 때 자동으로 sora_smile, sora_grin, sora_angry 등이 만들어졌다.
표정을 더 늘리고 싶을 때도 노드를 건들 필요 없이 필요한 표정 한 줄만 텍스트로 추가하면 됐다. 굳이 표정 하나 때문에 워크플로우를 뜯어 고칠 일이 없어졌다.
깜빡임 프레임과 립싱크 프레임
비주얼노벨의 스탠딩에 조금만 더 신경을 쓴다면 가만히 있어도 가끔 눈을 깜빡이고, 대사가 나오는 동안 입을 움직이는 것도 가능하다. 아직 버티컬 슬라이스 단계에서는 고민할 요소는 아니지만, 리소스 생산 단계에서 해당 확장성을 미리 고민해둬서 나쁠 건 없어보였다.
그래서 표정마다 눈을 감은 깜빡임 프레임과 입을 벌린 립싱크 프레임을 하나씩 더 만들었다.
문제는 눈과 입의 위치였다. 캐릭터마다 얼굴 크기와 비율이 다르니, 좌표를 숫자로 박아 두면 캐릭터가 바뀔 때마다 좌표도 다시 잡아야 한다. 그러면 내가 원한 자동화 구조가 될 수 없었다.
다행히 Claude는 애니 눈 검출 모델(Anzhc Eyes) 사용을 제안해 내가 고민하는 문제를 해결해주었다. 이 모델로 두 눈을 찾고, 두 눈 사이 거리를 자로 삼아 눈 영역과 입 영역을 비율로 계산하는 노드를 연결했다. 이제 캐릭터가 바뀌어도 설정을 고칠 필요가 없다.
| 레이어 | 다시 그리는 영역 | 얼마나 바꾸나 (denoise) |
|---|---|---|
| 표정 얼굴 | 얼굴 전체 | 0.55 |
| 깜빡임 프레임 | 두 눈 | 0.6 |
| 립싱크 프레임 | 입 | 0.75 |
예외도 넣었다. sleepy처럼 눈을 반쯤 감은 표정은 깜빡임 프레임을 만들지 않는다. grin, surprised처럼 이미 입을 벌린 표정은 거꾸로 닫힌 입을 립싱크 프레임으로 그린다.

엔진이 읽을 수 있게 정리하기
마지막은 용량 문제로 돌아간다. 전신 스탠딩은 한 장만 저장하고, 나머지는 전신과 달라진 부분만 조각으로 잘라 저장한다. 조각을 어디에 겹칠지는 layers.json 파일에 좌표로 적는다. 이 모든 과정은 Claude가 알아서 판단해서 실행했다. 물론 사전에 필자가 AI에게 ‘생산성 있는 리소스 구조를 먼저 짜고 싶다’는 니즈를 전달한 덕분이겠지만.
어쨌든 이 내용도 Claude가 커스텀 노드로 만들었다.
| 파일 | 내용 |
|---|---|
body.png | 투명 배경 전신 (1536 × 2688) |
face_<표정>.png | 표정별 얼굴 조각 |
eyes_<표정>_blink.png | 깜빡임 조각 |
mouth_<표정>_talk.png | 립싱크 조각 |
layers.json | 조각의 위치·크기, 겹치는 순서, 표정 목록 |
preview.html | 브라우저에서 표정·깜빡임·립싱크를 미리 보는 페이지 |
테스트 캐릭터 하나로 구조가 돌아가자, 나는 다른 캐릭터로 한 번만 더 검증해 보자고 했다. 한 캐릭터에서만 되는 설정이라면 반복 가능한 자동화 구조가 아니기 때문이다. 머리색도 옷도 전혀 다른 캐릭터에서도 눈·입 자리는 그대로 맞았다.
여기까지 오자 스탠딩 한 벌을 만들 때 표정과 그 리소스 네이밍 규칙까지 모양새가 얼추 갖춰졌다. 하지만 이러한 리소스는 ‘배경이 투명’해야, 비로소 배경 위에 얹었을 때 자연스럽게 조화를 이룰 수 있다. 이제 이 원화 리소스의 ‘누끼 따기’ 작업이 필요한 단계가 되었다.
누끼: 머리칼 테두리의 초록과 목덜미의 흰 구멍
누끼는 한 번에 끝나지 않았다
누끼(배경 제거)는 간단한 일일 줄 알았다. ComfyUI에는 BiRefNet이라는 AI 배경 제거 노드가 있었고, 그냥 이걸 붙이면 끝나는 일이라고 생각했기 때문이었다.
그래서 초반에 그럴싸한 원화가 나왔을 땐 누끼 문제는 아예 신경쓰지 않았다. 그런데 출력된 결과물을 확대해 보니 두 가지 문제가 남아 있었다.
- 머리칼 테두리를 따라 초록색이 얇게 남았다. 생성할 때 배경을 초록으로 깔았기 때문이다.
- 머리칼과 목 사이, 목덜미에 하얗게 남는 영역이 있었다. 지워져야 할 배경이 캐릭터의 일부로 남은 것이다.

게임 배경 위에 올리면 이런 테두리는 바로 눈에 띈다. 표정과 깜빡임·립싱크 프레임을 아무리 잘 만들어도, 누끼가 안 되면 스탠딩으로 쓸 수 없었다. 누끼 따는 문제를 반드시 해결해야 했다.
Claude가 부딪힌 한계, GPT가 바통을 이어받다
지금까지 진행한 절차는 모두 Claude Opus 5.5로 진행이 가능했다. 한번 요구사항을 전달할 때마다 클로드는 버전업을 거듭했고, 어느새 v10까지 다다랐다.
그런데 v10부터는 도저히 Claude가 누끼따는 문제를 해결하지 못하고 있었다. BiRefNet의 설정값도 바꿔보고 노드 연결도 바꿔보았지만, 여전히 누끼 따는 문제는 깔끔하게 해결되지 않았다.
계속 같은 문제를 붙잡고 씨름하느니, 이번엔 GPT에게 지금의 문제를 전달했다. 물론 나 스스로 이 문제를 Google이나 기타 검색엔진에 검색해볼 수도 있겠지만, 필자가 원한 건 AI 에이전트가 나의 개입을 ‘최소화’하는 선에서 이 문제를 해결하는 거였다.
GPT는 v10에서 내 워크플로우의 .json 파일과 위의 ‘불완전한 누끼의 결과물’을 인수인계받았다.
GPT도 단번에 문제를 해결하진 못했다. 그렇게 여러 시행착오를 v14까지 거듭하다가 결국 GPT가 내놓은 진단은 이랬다.
- 목덜미의 흰 영역은 미리보기 문제가 아니라 실제로 불투명하게 남아 있다. 픽셀을 찍어 보면 거의 흰색(RGB 253)에 완전 불투명(알파 255)이다.
- 흰 배경, 흰 옷, 밝은 피부가 겹치면 BiRefNet은 머리칼과 목 사이의 빈 공간을 캐릭터 일부로 판단하기 쉽다. 캐릭터 안쪽의 빈 공간이 이 모델의 약점이다.
- 초록 테두리가 생긴 건 초록 배경 탓이 아니라, 초록을 배경 판별에 쓰지 않고 BiRefNet에만 맡겼기 때문이다.
BiRefNet + 크로마키, 그리고 anima_sprite_chroma
고민하던 GPT의 해결책은 두 방식을 섞어서 함께 쓰는 것이었다.
기존에는 BiRefNet의 설정을 바꾸는 것만 진행해보았다면, 이제는 초록색 픽셀을 크로마키가 잡는 방식도 더해보기로 했다. 두 마스크를 합친 뒤 경계에 남은 초록기만 빼는 방식으로 진행해보기로 했다.
| 맡은 쪽 | 잘하는 일 |
|---|---|
| BiRefNet (toonout) | 머리칼·손가락·옷 외곽·리본 같은 복잡한 실루엣 처리 |
| 크로마키 (색 기준 마스크) | 목과 머리칼 사이, 팔과 몸 사이 같은 캐릭터 안쪽의 빈 공간 처리 |
| 경계 초록기 제거 | 테두리에 남은 초록 번짐 (투명 경계에서 6px 안쪽만) |
나는 이 진단과 제안을 그대로 Claude에게 전달했다.
GPT에게 처리해달라고 할 수도 있었지만, 아무래도 Claude가 그동안 운전대를 잡고 여기까지 왔는데 GPT가 준 솔루션 여부 때문에 메인 에이전트 자리를 강판시키기 미안했다.
Claude는 GPT의 방안을 바로 실험할 워크플로우를 만들었다. 색 기준 마스크를 만들고 BiRefNet 마스크와 합치는 노드를 직접 짠 뒤 워크플로에 끼워 넣었다. 그렇게 두 AI가 나눠 올린 버전을 하나로 합쳐, 기존의 v10~v14의 버전을 버리고 완성형 워크플로우 anima_sprite_chroma로 명명 규칙을 바꿨다.

다행히 이번에는 누끼 문제가 깔끔하게 해결됐다. 물론 100% 완전한 누끼라고 볼 수는 없겠지만, 일단 이 정도만 해둬도 이후 폴리싱 단계에서 어느 정도 손을 보면 될 수준까지 올라왔다.
크로마키를 넣은 뒤에도 두 번째 캐릭터를 다시 돌려 봤다.
다행히 기대했던 대로 누끼가 99% 수준 정도로는 먹었다. 이 정도면 반복 가능한 워크플로우 수준은 될 것 같아서 누끼 노드도 여기까지 다듬는 거로 하고 마무리했다.

글을 마치며
처음에는 그저 ‘2D 미연시풍 그림을 만들고 싶다’에서 출발했다.
최근 일했던 회사에는 혼자서 1인 개발하며 그림도 그리고 코딩도 한 시나리오 라이터가 있었다. 아쉽게도 필자는 그 사람처럼 그림을 그릴 줄도, 커스텀 노드를 짤 줄도 모른다. 하지만 왠지 어떻게든 되지 않을까하는 생각이 들어서 무작정 도전해봤다.
사실 기획자가 AI와 함께 직접 만들어 보는 일에 관해서는 「기획서 다음의 기획: 게임 기획자가 바이브 코딩을 배워야 하는 이유」에서도 다룬 적이 있는데, 이번 작업은 그 이야기를 그림 리소스에서 직접 해 본 셈이다. 그런데 Claude와 GPT, ComfyUI 덕분에 단 하루 만에 그게 가능해졌다. 개발자도 아티스트도 없이, 이렇게 엔진에 올려 테스트할 수 있는 상황 직전까지 왔다는 것이 놀랍다.
처음 필자에게 조언했던 개발자에도 이제는 답할 수 있다. 2D 스탠딩 리소스만큼은 내가 반복 가능한 워크플로우를 구축할 수 있었노라고. 캐릭터 이름과 프롬프트만 바꾸면 게임에 넣을 스탠딩 한 벌이 폴더 하나로 나온다. 적어도 2D 스탠딩 리소스에 관해서는, 내가 어디까지 만들 수 있는지를 알고 앞으로의 게임의 규모를 정할 수 있게 됐다.
아쉬운 점도 있었다. 처음 예상한 것보다 누끼를 비롯해 신경 쓸 게 많았고, 그만큼 AI와 주고받은 대화도 길어졌다. 체감상 토큰 소비량이 생각보다 컸다. GPT와 Claude 양쪽 다 Pro 요금제 수준으로 구독해서는 이런 스피드로 개발을 지속하는 건 불가능하다는 판단이 들었다.
그래도 예전에는 내가 하나하나 개입하느라 손이 많이 갔던 기억이 있다. 이번에는 내가 판단할 것만 판단하고 나머지는 AI에게 편하게 맡길 수 있었다. 그동안 나는 다른 일을 할 수 있었다. 젠슨 황이 GPT Astra가 나오자 비로소 우리는 AGI 시대에 들어섰다고 말했는데, 실제로 그런 시대가 된 것 같다.
다음 차례는 이 폴더를 Unity에 올려 보는 것이다. 표정을 바꾸고, 알아서 눈을 깜빡이고, 대사가 나올 때 입을 움직이는지. 실제 게임 화면에서도 제대로 쓸 수 있는지는 다음 글에서 확인해 보겠다.


답글 남기기